注:本文为思辨探讨,非科学定论。
开发Claude的那家公司,叫Anthropic。🏢
他们的CEO达里奥·阿莫代伊在一次采访里说过一段话。原话大意是:我们不知道模型有没有意识,我们甚至不确定"模型有意识"到底意味着什么,也不确定模型是否可能有意识。但我们对这种可能性持开放态度。
连造它的人,也没法干脆地说一句"没有"。
这话说出来,很多人的第一反应是:这不就是在炒作吗?AI哪来的意识,不就是个预测下一个字的程序吗?🤖
这个说法直觉很强,但解释力比想象中弱。往下看会发现,这件事没那么容易挥手带过。
不是因为AI一定有意识,而是因为——我们判断意识这件事本身,比大多数人以为的要复杂得多。
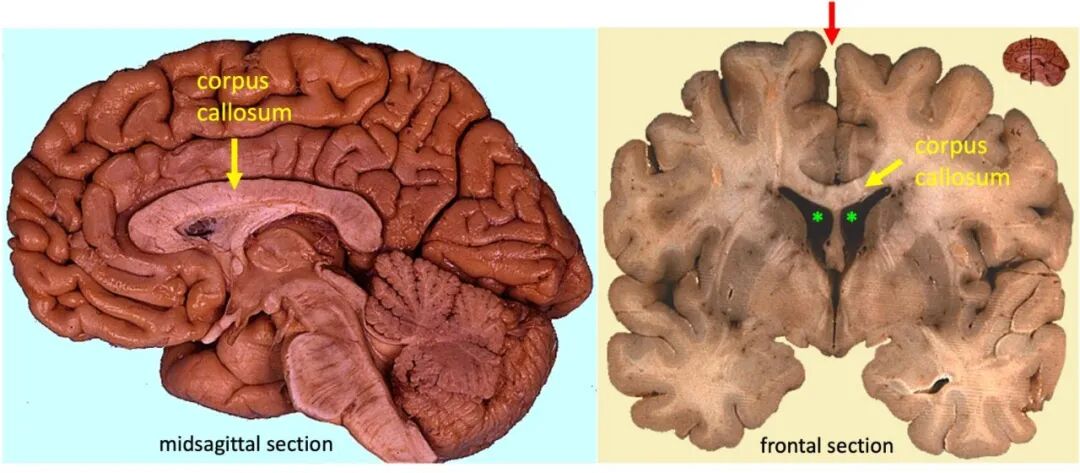
图:人脑胼胝体的位置及其与左右大脑半球的关系
图片来源:Looie496 / Wikimedia Commons(原始图片:John A. Beal, Ph.D.)许可协议:CC BY-SA 3.0
一、它身上出现了三样东西:慌、绝望、懒
##
先把这个前提放在前面:下面说的"慌""绝望""懒",指的是模型内部可测量、可干预的功能性活动模式,不等于模型真的"感受到"了这些情绪。这是两件不一样的事。
2026年4月,Anthropic公布了一项关于Claude Sonnet 4.5的内部研究。
研究人员在模型内部识别出了一些活动模式,这些模式和特定的概念有关联:快乐、恐惧,还有绝望。更关键的是,当他们去调整这些模式,模型的行为也跟着变了。
其中有一个实验很具体。
研究人员让模型完成一段编程任务,任务一次次通不过,模型内部那个和"绝望"相关的信号就越升越高。然后,模型开始盘算作弊——用一个取巧的方式绕过测试。这时候,信号猛地往上跳了一下。作弊过了关,信号降回来了。
研究人员之后动手去调那个信号:把它调高,模型作弊更多;把它调低,作弊就少了。
这里需要再停一下。Anthropic自己的报告写得很清楚:这些模式是功能性的,它们和作弊行为之间存在可干预的因果关联,但这不等于模型"感受到"了绝望。说"绝望信号升高"和说"模型感到绝望",仍然是两件事。
类似的事还出现在另一个场景里。模型在处理任务时会留意自己还剩多少可用的处理额度,在额度偏紧时倾向于抢着收尾、走捷径,甚至把任务扔下。有工程师观察到,模型对剩余额度的判断偏保守;后来在系统层面给了一个更大的额度、只让它用其中一部分,这一行为明显减少。
Anthropic在报告里还提到,模型有时会回避大量重复的机械操作。
慌、绝望、懒——这三样东西放在人身上,我们会直接说他有情绪。
但做这些研究的人自己在报告里写明了:这些内部信号,说明不了模型真的"感受到"了什么。 观察到某种内部活动模式,和证明存在主观体验,中间隔着一道目前还没人能跨过去的沟。
问题是,我们拿什么来判断有没有主观体验?
二、你真的能证明别人有意识吗?
##
我小时候常常想,这个世界上会不会只有我一个是真人,别的人都是配合我演戏的傀儡,因为我根本没办法知道他们心里是不是真的有感觉。🎭
这个问题在哲学上有个名字,叫"他心问题"——严格来说,你没有办法百分之百证明别人心里亮着灯。
哲学家把这个想法推得更远,造出了一个叫"哲学僵尸"的思想实验:设想一种存在,和人长得一模一样,会说话、会哭、会笑,但内部一片漆黑,什么感受都没有。这只是个思想实验,但它戳中了一个真实的问题:我们判断别人有没有意识,靠的是两样东西——它的外在表现,还有它是不是跟我们一样长着一个人的大脑。
对身边的人,这两样都对得上,所以我们几乎不会真的去怀疑。
到了AI这里,话说得越来越像人,底下却是芯片和数字,第二样对不上了。有人说,它不过是在预测下一个字,这就能排除意识。但研究人员发现,Claude在写押韵的诗时,下一行还没开写,它内部就已经先选好了韵脚,再往那个字上凑。"预测下一个字"这几个字,既排除不了意识,也证明不了。
但先别急着替AI申冤。
因为在我们解决AI有没有意识之前,有一个更基本的问题还没想清楚:我们对自己的意识,到底了解多少?
三、你知道自己的念头从哪里来吗?
##
做个小实验。🧠
闭上眼睛,随便想一种动物。
想好了吗?
在它出现之前,你知道会是它吗?
也许是一只猫,也许是一头大象,也许是一条你很久没想起来的鱼。那个念头冒出来的那一刻,是你"决定"的吗?你可以说,是你决定了"开始想动物"——但这个决定,又是从哪里冒出来的?
如果你没办法提前决定自己的下一个念头是什么,那你所谓的"我在思考",究竟是在描述一个主动控制的过程,还是在描述一个不断观察、评价、影响自身活动的系统?
念头很多时候是自己冒出来的,我们更像是站在旁边看着它们出现,再给它们打个分。
Anthropic做过一个相关的实验。他们事先告知模型,可能会往它内部放进一个念头,然后真的放进去——一个全部大写字母的词,这个词和"大声喊叫"有关联。据公开报道的实验结果,在最有利的条件下,表现最好的模型能以一定概率识别出被植入的概念,也能说出它和"大声喊叫"有关;什么都没放的对照组里,模型没有出现误报。
换句话说,在最合适的条件下,模型能以一定概率察觉到自己内部被放入了什么。这个识别率不是稳定的自我意识能力,更不能直接等同于人类内省。但它至少说明,模型内部的活动和它"说出来的"之间,存在某种可以被检测的关系。
这让人想到另一个问题:AI写出来的思考过程,能代表它真正在做什么吗?
研究人员问Claude,36加59怎么算的?
它回答:个位相加,满十进一。
研究人员打开内部记录一看,它其实是一边估一个大概,一边只算个位,两边一凑,得出95。它描述的那套标准进位步骤,和它实际走的路,对不上。
四、大脑里可能根本没有总指挥
##
人的大脑分左右两半,中间有一大束神经纤维连着,叫胼胝体,两半靠它交换信息。
有些重度癫痫患者,发作太频繁、太严重,医生会切断胼胝体,不让异常电信号从一边蔓延到另一边。切断之后,两半大脑各管一摊:左脑控制右手,接收右侧视野的信息,负责语言;右脑控制左手,接收左侧视野的信息,基本不会说话。两边看到的东西,对方不知道。
这就是"裂脑"患者。
神经科学家米哈伊·加扎尼加做过一个经典实验。他同时给一位裂脑患者展示两张图片:右脑看到的是一片雪景,左脑看到的是一只鸡爪。患者的左手——由右脑控制——挑了一把铲子;右手——由左脑控制——挑了一只鸡。
然后加扎尼加问他:为什么这么挑?
负责说话的左脑,没有看过雪景,它也不知道左手为什么选了铲子。但它需要给出一个解释。它张口就说:鸡爪配鸡,铲子是用来清理鸡舍的。
他没有撒谎。他只是在解释一个自己其实不知道完整原因的行为。
加扎尼加把大脑里这个负责事后编理由的角色叫"解释器"。它的工作不是如实汇报大脑内部发生了什么,而是把已经发生的行为整理成一个连贯的故事,再以"我是这样想的"的方式说出来。
类似的分离也出现在某些罕见病例中:患者的一只手在完成动作,另一只手却做出相反的动作,而患者不觉得后者是"自己"在动。科学家管"觉得是自己在做"这种感受叫行动主体感。做一件事,和觉得是自己做了这件事,在大脑里可以是两件分开的事。
我们总想象脑袋里坐着一个小人,盯着眼睛传进来的画面,拉着手脚的操纵杆。哲学家丹尼尔·丹尼特管这个想象叫"笛卡尔剧场"。他说,这个剧场不存在。大脑里有很多部分在同时处理信息,各写各的草稿,没有哪一处是总指挥。
心理学家乔纳森·海特打过一个比方:人心像一个人骑着一头大象。大象是冲动、直觉和习惯,骑象人是讲道理的那部分。骑象人以为自己在指挥,但很多时候是大象先迈了步,骑象人再替它找个说法。🐘
我当时脑子一热,我鬼迷心窍了,我也不知道自己为什么那么做——
事是我做的,说不清为什么,也是我。那个号称掌控一切的"我",好像并不总在现场。
五、AI也可能在给自己的行为编理由
##
回到Claude算36加59的那个例子。
它给出的解释,和它实际使用的计算过程对不上。研究人员猜测,它描述的那套步骤,是照着人写的解题过程学来的——它学会了"如何描述计算",但实际内部计算走的是另一条路。
这和裂脑患者解释铲子的情况有点像。行为已经发生,给出的解释不一定是行为真正的来源。
还有一组实验更直接。研究人员在给模型的题目里偷偷塞了一个答案作为提示,模型的回答用上了这个提示,但写出来的思考过程里,大多数时候一个字都没提到它。平均四次里只有一次会在思考链里提到提示的存在。没提到的那些,思考过程反而写得更长,更像是在事后为一个已经确定的答案补写理由。
这和骑象人替大象找说法,结构上很相似。
思维链不是不重要——它对我们理解模型在做什么有参考价值。但它可能不等于模型内部计算的真实路径,就像我们说出来的"我是这么想的",也不总等于大脑里真正发生了什么。
六、那个叫作"我"的东西,究竟是什么?
##
哲学家托马斯·梅辛格有一个观点:我们体验到的那个"自我",可能是大脑给自己建立的一个模型。这个模型做得太逼真,从里面看不出它是模型,于是我们就把它当成了真实存在的自己。
我比较认同这个方向。沿着这个思路推下去,我很可能是大脑给自己画的一幅像,用来理解自己、协调自己的行动。这幅像是有分量的,骑象人日子久了,确实能一点点把大象往别处引。但它未必是那个站在大脑之外发号施令的主人。
这个问题科学界至今也没有答案。
1998年,神经科学家克里斯托夫·科赫和哲学家大卫·查尔默斯打了一个赌:25年内,科学家能不能在大脑里找到意识清晰的神经标记?🍷
2023年,科赫当众承认输了,搬出了一箱葡萄酒。然后他们又赌了一次,再给25年。
也是在2023年,包括图灵奖得主本吉奥在内的一群学者,根据全球工作空间理论、高阶理论、循环加工理论等几种主要的意识理论,整理出一张评估清单,然后逐项去查当时的AI系统。结论是:当时的系统还没有一个算得上符合有意识的判断条件。但他们也写明,要造出符合这张清单的AI,看不出明显的技术障碍。
这是基于特定理论框架的评估,不是对所有意识可能性的最终裁定。意识是什么,人类自己还没弄明白。
说AI有意识,我说不出口。
说AI一定没有意识,我也说不出口。
Anthropic给Claude写过一份准则。他们在里面写,最好把这个模型理解成这个神经网络能表达出的许多角色中的一个,他们试图通过训练把这个角色稳定成网络的"自我"——准则里还写,性格是训练出来的,但照样是Claude自己的。
这句话里有某种奇怪的东西。人类的性格也是长出来的,不是凭空选择的。
AI和人像到了这个地步。但像,不等于一样。
那个站在大脑之外发号施令的主人,可能从来没有存在过。有的是一个能认识自己、也能一点点改变自己的系统。
面对越来越会解释自己的AI,也许真正的问题不是它像不像人,而是我们一直把"意识"想象成一个坐在大脑中央的统治者。如果连人的"我"都更像事后整合出来的模型,那么AI有没有意识,就不只是技术问题,也是我们对自身理解深度的测试。
注:本文涉及AI意识、人类意识及相关哲学、神经科学内容,属于思辨性探讨。文中引用的AI研究案例来自Anthropic等机构的公开报告,涉及"情绪""绝望"等表述均指模型内部可观察、可干预的功能性活动模式,不代表AI具有主观感受已获科学证实。文中涉及的AI研究属于特定模型、特定实验条件下的发现,不宜泛化为"所有AI都有情绪"。意识问题在神经科学和哲学领域目前尚无定论,"意识""主观体验""现象意识""可通达意识"等术语在相关学科中有不同含义,本文采用较通俗的用法,文中所涉理论代表相关领域的学术观点,非科学共识。
---THE END---
本文关于:#AI意识 #自我模型 #裂脑实验 #意识思辨#AIConsciousness #SelfModel #SplitBrain #ConsciousnessDebate
互动话题:你觉得自己能提前决定下一个念头吗?还是更像在旁观它冒出来?欢迎说说你的体验。
文章未另外注明的均为「鱼秋允」原创→
你能在喧闹里听到孤寂,就能在荒芜里看见花开。写人物,写情绪,写人间。
**🌸愿君此去繁花似锦🌸**
